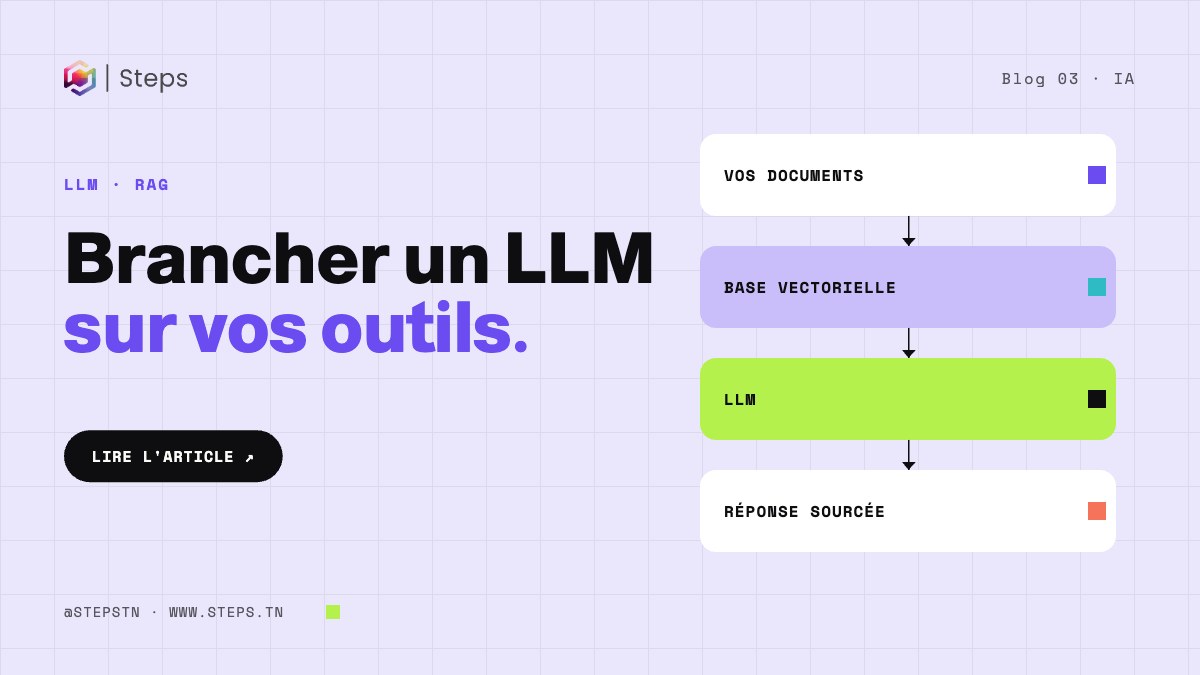

Intégrer un LLM (grand modèle de langage, comme ceux qui font fonctionner les assistants conversationnels) dans vos outils métier consiste à connecter le modèle à vos données et à vos applications pour qu’il réponde avec vos informations, dans vos écrans, selon vos règles. La méthode la plus répandue s’appelle le RAG : le système recherche d’abord les documents pertinents dans votre base, puis demande au modèle de rédiger une réponse fondée sur ces documents.
Les cas d’usage les plus rentables
- Assistant documentaire interne : répondre aux questions des équipes à partir des procédures, contrats et guides.
- Support client augmenté : proposer des réponses aux conseillers, résumer l’historique d’un client.
- Traitement de documents : extraire des informations de factures, de formulaires ou de courriers.
- Rédaction assistée : propositions commerciales, comptes rendus, fiches produits à partir de modèles.
- Recherche intelligente : retrouver une information dans des milliers de documents en posant une question en langage naturel.
Comment fonctionne une architecture RAG
- Préparation : vos documents sont découpés en passages et transformés en représentations numériques stockées dans une base vectorielle.
- Recherche : à chaque question, le système retrouve les passages les plus proches.
- Génération : le LLM rédige la réponse à partir de ces passages et peut citer ses sources.
- Contrôle : des règles filtrent les réponses hors sujet et respectent les droits d’accès de chaque utilisateur.
L’intérêt du RAG : le modèle n’a pas besoin d’être réentraîné, et la mise à jour d’un document suffit pour mettre à jour les réponses.
Choisir le bon modèle
Le choix dépend de trois critères : la qualité attendue, le coût par requête et la confidentialité. Les modèles commerciaux accessibles par API offrent le meilleur niveau de qualité et une mise en place rapide. Les modèles ouverts, hébergés sur votre infrastructure, donnent plus de contrôle sur les données au prix d’une exploitation plus lourde. Beaucoup d’entreprises combinent les deux selon la sensibilité des données.
Sécurité et confidentialité : les points à vérifier
- Les données envoyées au fournisseur sont-elles exclues de l’entraînement de ses modèles ?
- Où sont hébergés les traitements ?
- Chaque utilisateur ne voit-il que les documents auxquels il a droit ?
- Les échanges sont-ils journalisés pour audit ?
Les étapes d’un projet d’intégration
- Cadrage du cas d’usage et des indicateurs de succès.
- Audit des sources de données : qualité, formats, droits d’accès.
- Prototype avec un échantillon de documents et un groupe pilote d’utilisateurs.
- Évaluation de la qualité des réponses sur un jeu de questions de référence.
- Mise en production : intégration dans les outils existants, supervision, formation des équipes.
L’expertise STEPS
STEPS développe des applications LLM et d’IA générative intégrées aux outils de ses clients, avec une ingénierie data solide en amont. Pour identifier le cas d’usage le plus rentable dans votre organisation, réservez une session de cadrage.
Questions fréquentes
Le RAG (Retrieval-Augmented Generation) consiste à rechercher d’abord les documents pertinents dans votre base, puis à demander au LLM de rédiger une réponse fondée sur ces documents, ce qui limite les erreurs et permet de citer les sources.
Dans la plupart des cas, non. Une architecture RAG permet au modèle d’utiliser vos documents sans réentraînement, et une simple mise à jour des documents suffit.
Oui si vous choisissez un fournisseur qui n’utilise pas vos données pour l’entraînement, un hébergement adapté, une gestion des droits par utilisateur et une journalisation des échanges.
Un prototype sur un cas d’usage précis se construit en quelques semaines. La mise en production dépend du nombre d’outils à connecter et des exigences de sécurité.